Section 1 : Vue d'ensemble et importance architecturale
La version github-availability-report-septe marque un point d'évaluation pivot dans l'ingénierie continue de la fiabilité de l'infrastructure de GitHub. S'étendant sur les mois d'août et de septembre, cette période de rapport souligne une philosophie organisationnelle fondamentale : la disponibilité prime sur la capacité brute, qui elle-même prime sur la livraison de fonctionnalités. Suite à des incidents notables au début du cycle saisonnier, l'organisation d'ingénierie s'est fortement concentrée sur la correction des goulets d'étranglement des bases de données, l'optimisation des opérations en arrière-plan, la mise en place de contrôles de surcharge défensifs et la migration progressive des charges de travail de production principales vers Azure. Malgré des objectifs internes ambitieux, tels qu'un délai de déploiement manqué le 30 septembre pour tous les services de production dans la région Centre des États-Unis, la plateforme a atteint une résilience architecturale substantielle.
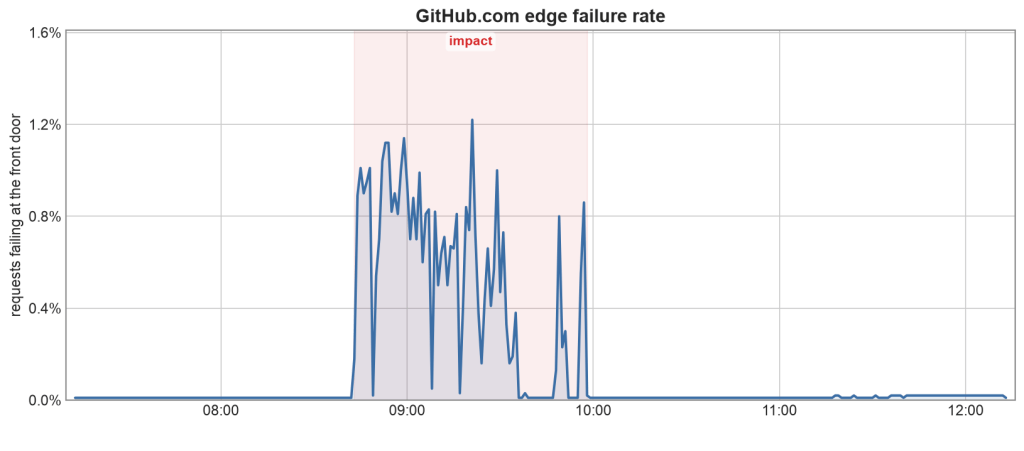
À la base, ce rapport de publication met en évidence des améliorations systémiques dans les systèmes à haute concurrence, notamment la mise à l'échelle de la base de données MySQL et la marge opérationnelle de GitHub Actions. En réduisant systématiquement la pression sur les bases de données partagées héritées, en mettant en œuvre des paradigmes de confinement des pannes plus intelligents pour les demandes d'extraction (pull requests) et en élargissant l'empreinte régionale d'Azure — gérant plus de 65 % du trafic de lecture des applications principales et 80 % des tâches de traitement de flux —, GitHub élimine méthodiquement les points de défaillance uniques. Néanmoins, les incidents du monde réel, notamment un événement de saturation de connexion à la base de données le 13 septembre et une panne de la revue de code Copilot le 28 septembre, démontrent que le renforcement architectural continu reste une nécessité absolue pour les plateformes de développeurs à hyper-échelle.
Section 2 : Améliorations clés et ergonomie pour les développeurs
L'ergonomie des développeurs et la réactivité du système ont connu des améliorations majeures grâce à des optimisations ciblées de la base de données et du cache. Plus particulièrement, les équipes d'ingénierie ont supprimé 24 tables du noyau d'authentification de la plus ancienne base de données partagée de GitHub, éliminant environ un million de requêtes par seconde de ses réplicas. De plus, le cluster de bases de données des tickets et des demandes d'extraction a fait l'objet d'un effort massif de nettoyage des données, purgeant environ 980 millions de lignes d'historique de modification inutiles et récupérant 1,8 téraoctet de stockage. Ces processus de nettoyage continus ont réussi à freiner la croissance incontrôlée des données historiques, contribuant à une baisse de 77 % des interblocages hebdomadaires par rapport à leur pic de juin.
GitHub Actions a également bénéficié d'ajustements cruciaux de la marge opérationnelle grâce à la mise en cache ciblée de l'infrastructure. Les mises à jour de production ont réduit les opérations Redis mesurées d'environ 28 % et l'utilisation relative du CPU d'environ 30 %. Parallèlement, un cache d'infrastructure dédié a réduit la consommation de bande passante Redis de 84 %, diminué les temps de réponse moyens de 66 %, accéléré les temps de réponse médians pour les requêtes d'inventaire principales de 96 % et réduit les requêtes en file d'attente de 95 %. Sur le plan de la résilience, les protocoles d'isolement des pannes permettent désormais à environ la moitié du trafic d'extraction échantillonné de maintenir une fonctionnalité limitée lorsqu'une dépendance partagée tombe en panne, tandis que la logique de routage automatisé met dynamiquement à l'échelle les groupes de travail en cas de pics de trafic soudains.
Section 3 : Matrice de comparaison architecturale
| Métrique de performance | Référence précédente | github-availability-report-septe | Impact architectural |
|---|---|---|---|
| Latence de lecture de l'application principale | Forte variance lors de la charge de pointe | Stabilisée via le routage Azure | 65,4 % des lectures principales gérées de manière fiable sur l'infrastructure Azure |
| Charge de connexion à la base de données | Sujette à la saturation via les tâches d'arrière-plan | Protégée par une limitation sensible à la charge | Empêche l'épuisement des connexions à la base de données principale lors des tâches en arrière-plan |
| Profondeur de la file d'attente GitHub Actions | File d'attente élevée sous forte concurrence | Réduite de 95 % | La mise en cache de l'infrastructure accélère considérablement les requêtes d'inventaire |
| Stockage de l'historique des modifications | Croissance illimitée des tables héritées | 1,8 To de stockage récupérable libéré | 980 millions de lignes inutiles purgées, réduisant la fréquence des interblocages de 77 % |
Section 4 : Changements cassants et mises en garde concernant la migration
Cette version n'introduit aucun changement d'API cassant direct pour les développeurs externes, maintenant une stricte rétrocompatibilité avec les points de terminaison REST et GraphQL existants. Cependant, les migrations internes et les règles de gouvernance de la plateforme nouvellement appliquées introduisent des mises en garde opérationnelles critiques. La migration régionale agressive vers Azure Central US s'est heurtée à des arrêts brutaux en raison d'une capacité inégale des zones de disponibilité, nécessitant des pauses de déploiement temporaires et des modifications structurelles des scripts de basculement d'urgence automatisés. Plus précisément, les processus automatisés qui déconnectaient auparavant les copies de bases de données de Central US lors des transferts planifiés ont été temporairement désactivés pour éviter tout impact inattendu sur les clients.
De plus, les contrôles de surcharge de production nouvellement mis en place rejettent activement les requêtes Web et API de moindre priorité lors d'événements de haute saturation afin de protéger les flux de travail critiques des développeurs. Les intégrations reposant sur des boucles de nouvelle tentative illimitées ou manquant de repli exponentiel peuvent subir des rejets de connexion accélérés si elles submergent des points de terminaison saturés pendant les fenêtres de dégradation du système.
Section 5 : Guide de mise à niveau étape par étape
Pour aligner les services internes et les configurations auto-hébergées sur les normes actuelles de disponibilité et de résilience de GitHub, les équipes d'ingénierie doivent adopter les pratiques opérationnelles suivantes :
Mettre en œuvre des délais d'attente stricts pour les dépendances de bases de données : S'assurer que tous les gestionnaires de services en aval appliquent des limites de délai strictes lors de l'interrogation de magasins relationnels partagés, évitant ainsi l'épuisement du pool de threads lors d'une dégradation transitoire.
import socket
from sqlalchemy import create_engine

# Enforce strict connect and read timeouts on database engines
engine = create_engine(
    "mysql+pymysql://user:pass@localhost/db",
    connect_args={"connect_timeout": 3, "read_timeout": 5}
)
Incorporer des coupe-circuits et des nouvelles tentatives idempotentes : Mettre à jour les couches d'intégration des webhooks et de création de jetons pour éviter les tempêtes de nouvelles tentatives agressives qui exacerbent la saturation de la base de données principale.
- Ajuster les mesures de protection du traitement en arrière-plan : S'assurer que les tâches de nettoyage ou de synchronisation des données internes surveillent explicitement la santé des connexions à la base de données principale et la charge des requêtes, plutôt que de se contenter de suivre le retard des réplicas.