Sección 1: Resumen Ejecutivo y Significado Arquitectónico
El lanzamiento de github-availability-report-septe marca un punto de evaluación crucial en la ingeniería continua de confiabilidad de la infraestructura de GitHub. Abarcando los meses de agosto y septiembre, este período de informes subraya una filosofía organizacional fundamental: la disponibilidad tiene prioridad sobre la capacidad bruta, la cual a su vez tiene prioridad sobre la entrega de características. Tras incidentes notables a principios del ciclo estacional, la organización de ingeniería se concentró fuertemente en remediar los cuellos de botella en las bases de datos, optimizar las operaciones en segundo plano, establecer controles de sobrecarga defensivos y migrar constantemente las cargas de trabajo de producción principales a Azure. A pesar de objetivos internos agresivos, como un plazo de implementación fallido el 30 de septiembre para todos los servicios de producción en la región Centro de EE. UU., la plataforma logró una resistencia arquitectónica sustancial.
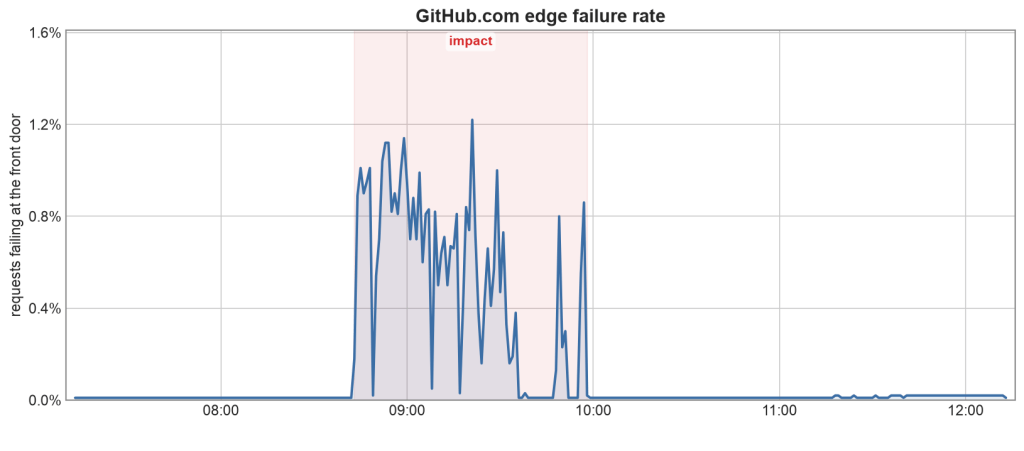
En su núcleo, este informe de lanzamiento destaca mejoras sistémicas en sistemas de alta concurrencia, notablemente el escalado de bases de datos MySQL y el margen operativo de GitHub Actions. Al reducir sistemáticamente la presión sobre las bases de datos compartidas heredadas, implementar paradigmas más inteligentes de contención de fallas para las solicitudes de extracción (pull requests) y expandir la huella regional de Azure —manejando más del 65% del tráfico de lectura de aplicaciones principales y el 80% de las tareas de procesamiento de flujos—, GitHub está diseñando sistemáticamente la eliminación de los puntos únicos de falla. Sin embargo, los incidentes del mundo real, incluido un evento de saturación de conexiones a bases de datos el 13 de septiembre y una interrupción en la revisión de código de Copilot el 28 de septiembre, demuestran que el endurecimiento arquitectónico continuo sigue siendo una necesidad absoluta para las plataformas de desarrolladores a hiperescala.
Sección 2: Mejoras Principales y Ergonomía del Desarrollador
La ergonomía del desarrollador y la capacidad de respuesta del sistema experimentaron importantes mejoras debido a optimizaciones específicas en bases de datos y almacenamiento en caché. Lo más destacable es que los equipos de ingeniería eliminaron 24 tablas del núcleo de autenticación de la base de datos compartida más antigua de GitHub, reduciendo aproximadamente un millón de consultas por segundo en sus réplicas. Además, el clúster de bases de datos de incidencias y solicitudes de extracción se sometió a un esfuerzo masivo de saneamiento de datos, purgando aproximadamente 980 millones de filas innecesarias del historial de ediciones y recuperando 1.8 terabytes de almacenamiento recuperable. Estos procesos de limpieza continua frenaron con éxito el crecimiento ilimitado de datos históricos, contribuyendo a una caída del 77% en los interbloqueos (deadlocks) semanales en comparación con su pico de junio.
GitHub Actions también recibió ajustes cruciales en su margen operativo mediante el almacenamiento en caché de infraestructura específico. Las actualizaciones de producción redujeron las operaciones de Redis medidas en aproximadamente un 28% y la utilización relativa de la CPU en alrededor de un 30%. Simultáneamente, un caché de infraestructura dedicado redujo el consumo de ancho de banda de Redis en un 84%, redujo los tiempos de respuesta promedio en un 66%, aceleró los tiempos de respuesta medianos para solicitudes de inventario principales en un impresionante 96% y disminuyó las solicitudes en cola en un 95%. En el frente de la resiliencia, los protocolos de aislamiento de fallas ahora permiten que aproximadamente la mitad del tráfico de solicitudes de extracción muestreado mantenga una funcionalidad limitada cuando falla una dependencia compartida, mientras que la lógica de enrutamiento automatizado escala dinámicamente los grupos de trabajadores durante picos repentinos de tráfico.
Sección 3: Matriz de Comparación Arquitectónica
| Métrica de Rendimiento | Línea Base Anterior | github-availability-report-septe | Impacto Arquitectónico |
|---|---|---|---|
| Latencia de Lectura de la Aplicación Principal | alta variabilidad durante la carga pico | Estabilizada mediante enrutamiento de Azure | El 65.4% de las lecturas principales se manejan de manera confiable en la infraestructura de Azure |
| Carga de Conexión de Base de Datos | Propensa a la saturación por trabajos en segundo plano | Defendida por limitación (throttling) consciente de la carga | Previene el agotamiento de las conexiones de la base de datos principal durante tareas en segundo plano |
| Profundidad de Cola de GitHub Actions | Alta cola bajo alta concurrencia | Reducida en un 95% | El almacenamiento en caché de la infraestructura acelera significativamente las solicitudes de inventario |
| Almacenamiento del Historial de Ediciones | Crecimiento ilimitado de tablas heredadas | 1.8 TB de almacenamiento recuperable liberado | Se purgaron 980M de filas innecesarias, reduciendo la frecuencia de interbloqueos en un 77% |
Sección 4: Cambios Disruptivos y Advertencias de Migración
Este lanzamiento no introduce cambios disruptivos directos en la API para desarrolladores externos, manteniendo una estricta compatibilidad con versiones anteriores de los puntos finales (endpoints) REST y GraphQL existentes. Sin embargo, las migraciones internas y las reglas de gobernanza de la plataforma recién aplicadas introducen advertencias operativas críticas. La migración regional agresiva al Centro de EE. UU. en Azure encontró topes estrictos debido a la capacidad desigual de la zona de disponibilidad, lo que requirió pausas temporales en el despliegue y alteraciones estructurales en los scripts automatizados de conmutación por error de emergencia (failover). Específicamente, los procesos automatizados que previamente desconectaban las copias de bases de datos del Centro de EE. UU. durante las transferencias planificadas se han deshabilitado temporalmente para evitar un impacto inesperado en los clientes.
Además, los controles de sobrecarga de producción recién implementados descartan activamente las solicitudes web y de API de menor prioridad durante eventos de alta saturación para proteger los flujos de trabajo críticos de los desarrolladores. Las integraciones que dependen de bucles de reintento ilimitados o que carecen de retroceso exponencial (exponential backoff) pueden experimentar un rechazo acelerado de conexiones si saturan los puntos finales durante las ventanas de degradación del sistema.
Sección 5: Guía de Actualización Paso a Paso
Para alinear los servicios internos y las configuraciones autohospedadas con los estándares actuales de disponibilidad y resiliencia de GitHub, los equipos de ingeniería deben adoptar las siguientes prácticas operativas:
Implementar tiempos de espera rápidos (Fail-Fast) para dependencias de bases de datos: Asegúrese de que todos los controladores de servicios descendentes apliquen límites estrictos de tiempo de espera al consultar almacenes relacionales compartidos, evitando el agotamiento del grupo de subprocesos durante una degradación transitoria.
import socket
from sqlalchemy import create_engine

# Aplicar tiempos de espera estrictos de conexión y lectura en los motores de bases de datos
engine = create_engine(
    "mysql+pymysql://user:pass@localhost/db",
    connect_args={"connect_timeout": 3, "read_timeout": 5}
)
Incorporar disyuntores (Circuit Breakers) y reintentos idempotentes: Actualice las capas de integración de webhooks y creación de tokens para evitar tormentas de reintentos agresivas que exacerben la saturación de la base de datos principal.
Ajustar las salvaguardas de procesamiento en segundo plano: Asegúrese de que los trabajos internos de limpieza de datos o sincronización monitoreen explícitamente la salud de la conexión de la base de datos principal y la carga de consultas, en lugar de rastrear únicamente el retraso de las réplicas.